목차
“AI 모델 학습 기반 위협 감지는 사전 대응의 시작점”
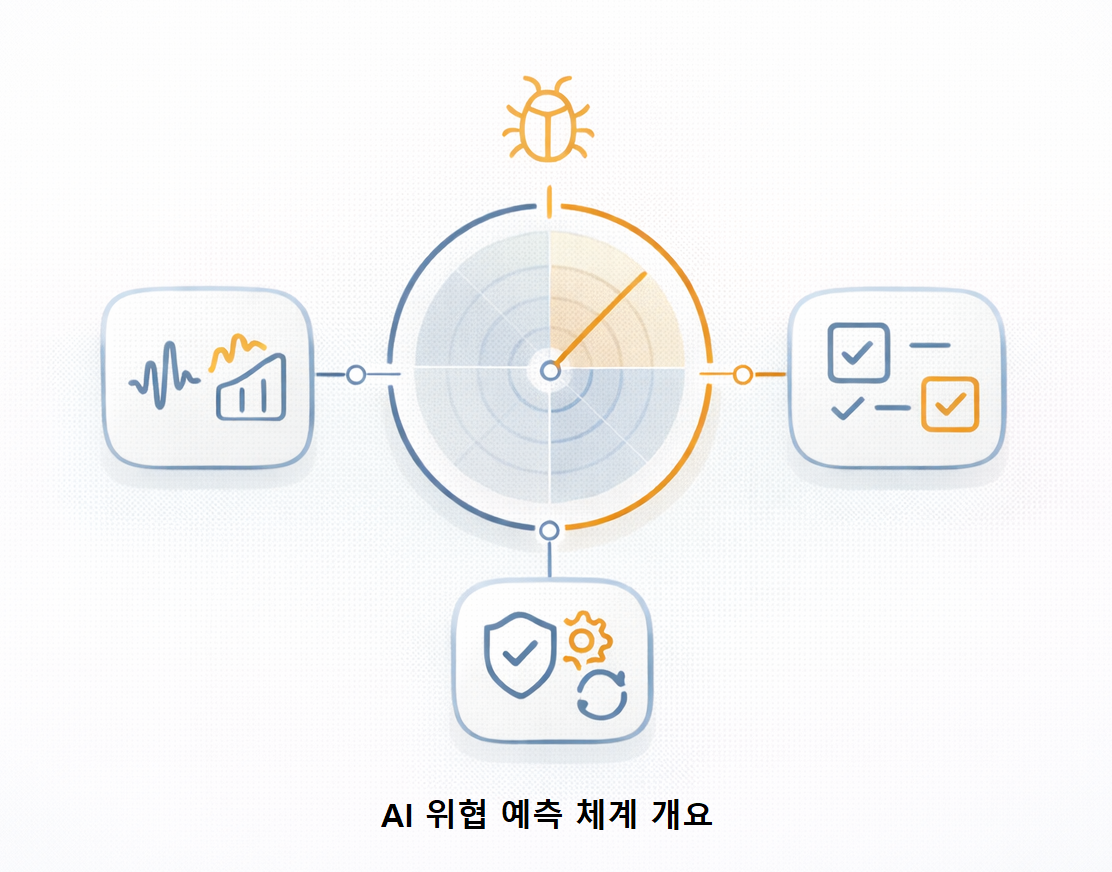
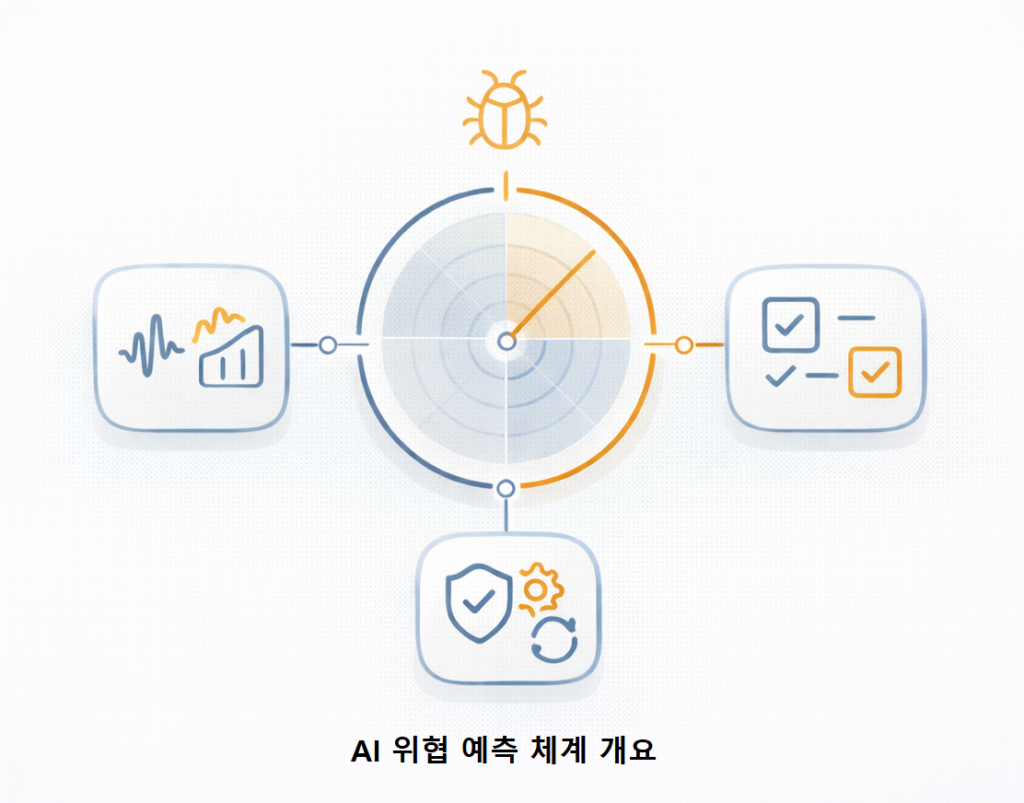
AI 기반 위협 예측은 “경보를 더 많이 만드는 기술”이 아닙니다.
핵심은 어떤 징후가 위험으로 커질지를 학습하고,
운영 환경에서 우선순위를 선제적으로 바꾸는 체계를 만드는 것입니다.
즉, 모델 자체보다 데이터 품질(수집·정규화) + 학습 프로세스(검증·재학습) + 실시간 모니터링(드리프트·오탐 관리)가 성패를 가릅니다.
– AI 기반 위협 예측 체계 구축, 무엇을 “예측”하나?
예측의 대상은 단일 이벤트가 아니라 “리스크의 흐름”입니다.
실무에서는 보통 아래 질문에 답하도록 설계합니다.
- 지금 가장 위험해지는 계정/자산은 무엇인가?
- 어떤 패턴이 침해(계정 탈취·권한 남용·내부 확산)로 이어질 가능성이 큰가?
- 오늘 대응 인력이 한정이라면 먼저 처리해야 할 알림은 무엇인가?
이 관점이 잡히면, 이후 절차(수집→학습→모니터링)도 흔들리지 않습니다.
– 데이터 수집: “학습 가능한 데이터”를 만드는 단계
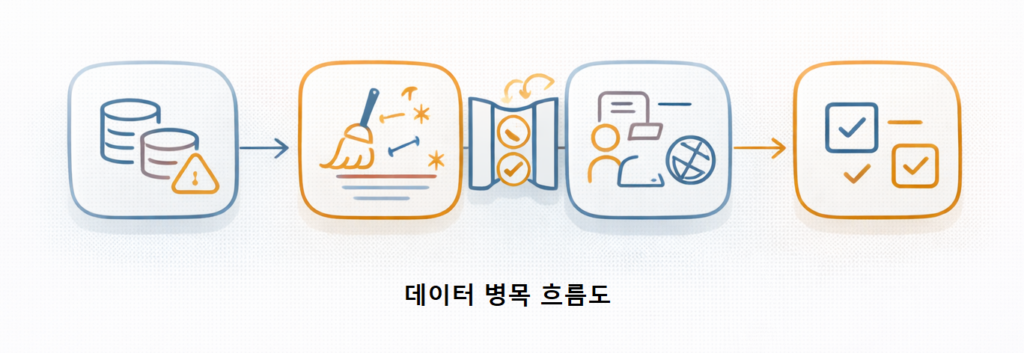
AI 위협 예측에서 데이터 수집은 “모으기”가 아니라 정리된 형태로 꾸준히 쌓이게 만들기입니다.
아래 체크를 빠뜨리면, 모델 성능은 올라가지 않고 오히려 운영 부담만 커집니다.
1) 소스 우선순위(처음부터 다 모으지 말기)
- 인증/권한: SSO, IAM, AD, MFA 이벤트
- 엔드포인트: EDR 행위, 프로세스/파일/레지스트리 변경
- 네트워크: 프록시/DNS/방화벽, 동서 트래픽 흐름
- 클라우드: 감사 로그(변경·권한·스토리지 공개 등)
2) 필드 표준화(모델이 이해할 공통 언어)
- 최소한 아래 6개는 “항상 존재”해야 합니다.
- 시간(정확한 타임스탬프)
- 주체(사용자/서비스 계정)
- 대상(호스트/자산/리소스)
- 출처(소스 IP/지역/디바이스)
- 행위 타입(로그인, 권한 변경, 실행 등)
- 결과(성공/실패/차단)
3) 라벨/정답 데이터(학습의 연료)
- 사건(Incident) 티켓, 조사 결과, 실제 차단/격리 기록
- 오탐/정탐 태그(후속 튜닝을 위해 필수)
- 중요 자산/관리자 계정/외부 노출 같은 자산 태그
– 학습 프로세스: 모델을 “운영 가능한 품질”로 만드는 절차
학습은 한 번 돌리고 끝내면 실패합니다.
아래처럼 재현·검증·배포·재학습을 한 덩어리로 묶어야 합니다.
1) 문제 정의를 좁게 잡기(첫 성공이 중요)
- 예: “계정 탈취 조기 징후 분류”, “권한 남용 탐지”, “내부 확산 위험 점수화”
- 너무 넓게 시작하면 라벨이 부족해지고, 결과 해석도 어려워집니다.
2) 베이스라인부터 만들기(룰 기반 + 모델 기반)
- 룰 기반(상관분석/임계치)으로 “최소 성능” 확보
- 그 위에 모델로 우선순위 정교화(오탐 감소, 조기 탐지 개선)
3) 검증 기준을 운영 지표로 고정
- 단순 정확도보다 중요한 것:
- 조기 탐지(lead time): 사건 전 얼마나 빨리 잡았나
- 오탐 비용: 알림 폭주로 운영이 멈추지 않나
- 재현성: 같은 입력에 같은 결과가 나오나
4) 안전장치 포함 배포(승인/제한/원복)
- 자동 조치는 단계적으로:
- (안전) 증거 수집 → 티켓 생성 → 알림 강화
- (중간) 임시 제한(세션 리셋, MFA 재요구)
- (고위험) 차단/격리/정책 변경(승인 게이트 필수)
– 실시간 모니터링: “모델이 살아있는지” 감시하는 단계
1) 운영 모니터링(시스템 관점)
- 데이터 수집 지연/누락
- 파싱 실패/필드 변경
- 파이프라인 처리량/큐 적체
2) 모델 모니터링(품질 관점)
- 드리프트 : 입력 분포가 바뀌었는지(새 서비스, 새 권한 체계, 새 공격 패턴)
- 오탐/미탐 추세 : 특정 팀/자산에서만 경보가 튀는지
- 재학습 트리거 : 라벨 누적, 신규 공격 캠페인, 정책 변경 시점
– 체크리스트: 구축 절차를 “멈추지 않게” 만드는 최소 조건
- 데이터 소스 우선순위가 정해져 있고, 핵심 필드가 표준화돼 있다
- 정탐/오탐 라벨이 운영 흐름(티켓/조사)에서 자동으로 쌓인다
- 모델 성능을 운영 지표(조기 탐지/오탐 비용)로 평가한다
- 자동 조치는 승인 게이트/범위 제한/원복 루틴이 기본값이다
- 드리프트 감지와 재학습 트리거가 정해져 있다
– FAQ
Q1. AI 기반 위협 예측이 안되면(정확도가 안 나오면) 어디부터 봐야 하나요?
- 대부분 모델이 아니라 데이터입니다.
- (1) 핵심 필드 누락(사용자/자산/시간), (2) 로그 지연·누락, (3) 라벨 부족(정탐/오탐)이 가장 흔한 원인입니다.
Q2. 리스크는 뭐가 가장 큰가요?
- 가장 큰 리스크는 오탐으로 인한 업무 중단입니다. 모델이 “위험”이라고 해도 자동 차단이 바로 실행되면 운영 신뢰가 무너집니다. 고위험 조치는 항상 승인/제한/원복을 붙여야 합니다.
Q3. 처음에는 어떤 범위로 시작하는 게 안전한가요?
- “증거 수집 자동화 + 우선순위 점수화”부터 시작하는 게 안전합니다. 차단/격리는 나중에, 근거와 운영 루틴이 충분히 쌓인 뒤 단계적으로 확대하세요.
Q4. 자동 조치가 잘못 실행됐을 때 원복(롤백)은 어떻게 설계하나요?
- 원복은 문서가 아니라 플레이북(자동 절차)이어야 합니다.
- 무엇을 바꿨는지(정책/격리/권한)를 기록하고
- 같은 체인에서 되돌리는 단계(롤백)를 즉시 실행 가능하게 만들고
- 원복 실행 권한과 승인 기준을 미리 정의해야 안전합니다.
Q5. 운영하면서 예측 정확도를 어떻게 “같이” 높이나요?
- 정답 데이터를 운영에서 계속 쌓아야 합니다. 티켓/조사 결과가 정탐/오탐 라벨로 남고, 그 라벨이 재학습으로 연결되도록 “루프”를 설계하면 시간이 갈수록 정확도가 올라갑니다.
– 마무리: AI의 예측 정확도를 운영과 함께 높이자
AI 기반 위협 예측 체계는 모델보다 절차가 먼저입니다.
데이터 수집 → 학습 프로세스 → 실시간 모니터링을 운영 루틴으로 고정하고,
위험 조치에는 승인과 원복을 기본값으로 두면,
예측 정확도는 운영과 함께 꾸준히 올라갑니다.