목차
“AI 학습 데이터 자체도 보호 대상이다”
예측형 보안은 “모델이 똑똑해지는 것”보다 데이터가 안전하게 축적·활용되는 구조가 먼저입니다.
학습/추론에 쓰이는 로그·자산 인벤토리·권한 이벤트·사고 티켓에는 개인식별정보(PII)나
내부 민감정보가 섞이기 쉽고, 데이터가 한 번 새면 모델보다 더 큰 손실로 이어집니다.
이 글은 데이터 암호화 → 접근 통제 → 로그 관리 순서로,
예측형 보안 데이터(학습/리포트/운영 파이프라인)를 안전하게 지키는 절차를 정리합니다.
– 예측형 보안 데이터 보호 절차에서 먼저 정해야 할 범위
데이터 보호는 “암호화 툴”부터가 아니라 보호 대상 정의부터 시작합니다.
- 원천 데이터: SIEM/EDR/클라우드 감사 로그, 네트워크/DNS, IAM/AD 이벤트
- 가공 데이터: 정규화/피처(Feature) 테이블, 라벨(정탐/오탐), 리스크 스코어
- 운영 데이터: 케이스/티켓, 조치 내역, 원복 기록
- 산출물: 리포트(PDF/대시보드), 모델 아티팩트(가중치/피처 통계)
여기서 핵심 원칙은 2개입니다.
- 필요한 것만 남긴다(최소 수집/최소 보관)
- 흐름 전체를 묶어서 통제한다(저장소만 잠그면 끝이 아님)
– 데이터 암호화: “저장”과 “전송”을 분리해서 설계하기
암호화는 보통 “저장 암호화(At-rest)”만 켜고 끝내기 쉬운데,
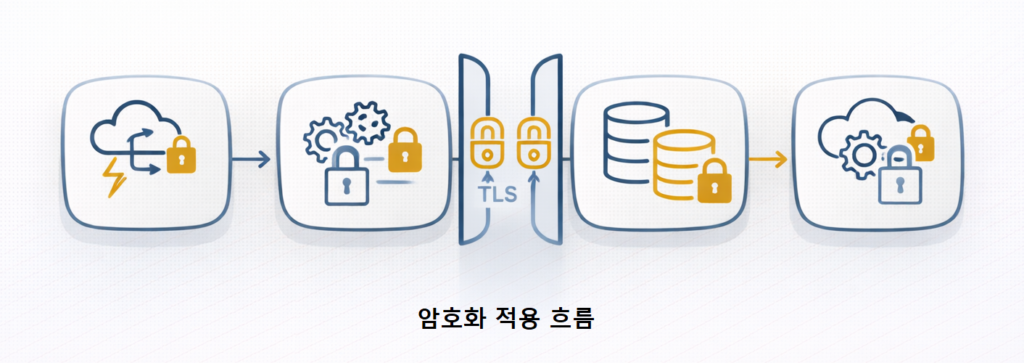
예측형 보안은 파이프라인이 길어서 전송(실시간 수집) + 중간 처리(ETL/스트리밍) + 저장(데이터 레이크/웨어하우스)까지 함께 봐야 합니다.
1) 저장 암호화(At-rest)
- 로그 저장소, 피처 스토어, 모델 아티팩트 저장소에 기본 암호화 강제
- 별도 키를 쓰는 구간을 정해 민감 데이터는 분리 보관(권한/키도 분리)
2) 전송 암호화(In-transit)
- 수집 에이전트 → 수집 서버, 수집 서버 → 분석/학습 영역 간 구간에 TLS 강제
- “내부망이니까 괜찮다”는 가정은 금물(측면 이동 리스크)
3) 키 관리(운영에서 제일 자주 깨지는 부분)
- 키 회전 주기, 만료/교체 시나리오를 “정책”이 아니라 운영 절차로 고정
- 데이터/서비스별로 키 범위를 나눠, 한 키가 새도 피해를 제한
– 접근 통제: 학습 데이터는 “권한”이 아니라 “정책”으로 다루기
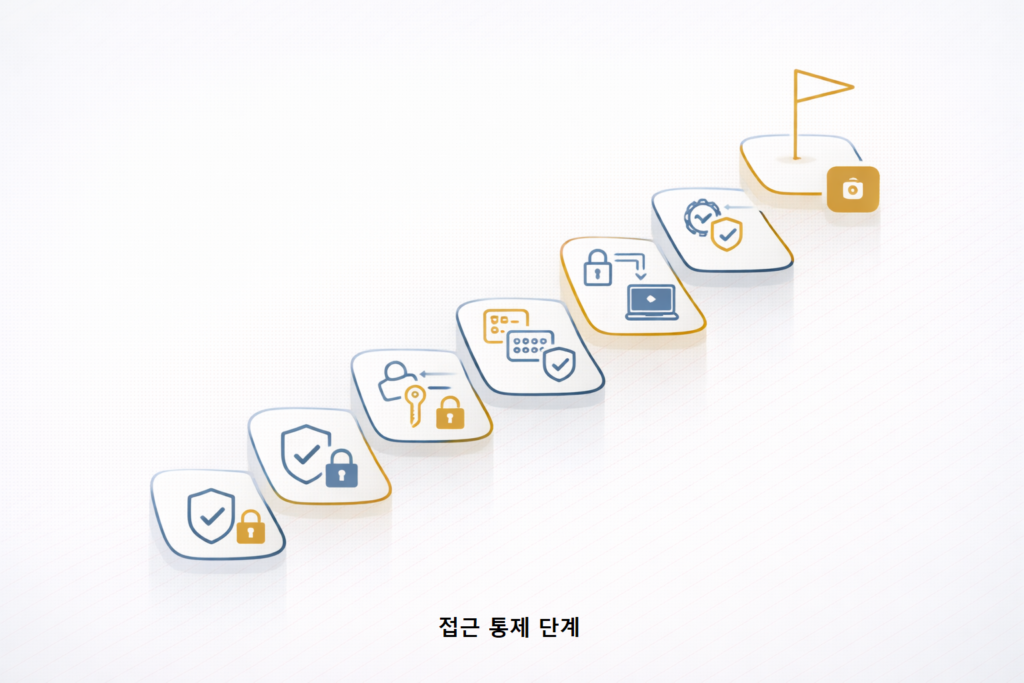
예측형 보안 데이터는 한 번 권한이 열리면 “복사/다운로드”로 빠져나가기 쉽습니다.
따라서 접근 통제는 단순 RBAC(역할)보다 정책 기반(조건/맥락)이 중요합니다.
1) 최소권한 + 분리 원칙
- 수집/정규화/학습/리포팅 역할을 분리하고, 서로의 원천에 “읽기만” 허용
- 운영자 편의로 “관리자 권한”을 공유하면, 데이터는 언젠가 새게 됩니다
2) 민감 필드 마스킹/토큰화
- PII(사용자 식별자, 이메일, 전화 등)는 원천에서부터 마스킹 가능 여부를 우선 검토
- 분석에 필요한 경우에도 “원문” 대신 대체 키(해시/토큰) 중심으로 설계
3) 디바이스/환경 조건(Devices 관점)
- 학습 데이터 접근은 관리 디바이스(관리형 노트북/VDI)로 제한
- 개인 장비/비관리 장비에서의 다운로드를 기본 차단(최소한 경고+승인)
4) “모델 아티팩트”도 보호 대상
- 모델 가중치/피처 통계만으로도 민감 정보가 유추될 수 있습니다
- 모델/데이터 버전별 접근 권한을 분리하고, 외부 반출 프로세스를 명확히 둡니다
– 로그 관리: 데이터 보호의 완성은 “감사 가능성”이다
데이터를 잠그는 것만큼 중요한 게 누가, 언제, 무엇을, 왜 했는지 남기는 것입니다.
1) 접근 로그는 “증적 품질”로
- 조회/다운로드/대량 추출/권한 변경을 분리 기록
- 관리자 행동은 별도 추적(감사 계정/관리 세션)
2) 보존 기간과 파기 루틴
- 학습용 원천 로그: “필요 최소 기간” + “재학습에 필요한 범위”로 합의
- 라벨/조치/원복 기록: 감사/사고 대응을 고려해 별도 보존
- 파기는 수동이 아니라 자동 파기(정책 기반)로 고정
3) 이상 징후 룰(데이터 유출 전조)
- 야간 대량 조회, 비정상 지역/디바이스 접근, 짧은 시간 반복 다운로드 등
- 예측형 보안 시스템 자체가 “자기 데이터를 지키는 탐지”를 갖도록 설계
– 체크리스트: 예측형 보안 데이터 보호 절차 빠른 점검
- -원천/가공/운영/산출물로 보호 대상을 구분했다
- 저장(At-rest) + 전송(In-transit) 암호화를 모두 강제했다
- 키 회전/만료 시나리오가 운영 절차로 존재한다
- 최소권한 + 마스킹/토큰화 + 관리 디바이스 제한이 적용됐다
- 접근/다운로드/권한 변경 로그가 증적으로 남는다
- 보존/파기 정책이 자동화되어 있고, 예외는 만료가 있다
– FAQ
Q1. 데이터 암호화가 안되면(성능/호환 문제로) 무엇부터 적용하나요?
- 우선순위는 전송 암호화(TLS) → 저장 암호화(핵심 저장소부터) → 키 관리 체계 순서가 안전합니다. 특히 수집 구간이 평문이면, 저장소만 암호화해도 중간에서 새어 나갈 수 있습니다.
Q2. 예측형 보안 데이터 보호에서 가장 큰 리스크는 무엇인가요?
- 가장 큰 리스크는 “학습 데이터는 내부 자료니까 괜찮다”는 인식입니다. 운영 로그에는 권한·자산·행위가 담겨 있어 공격자에게 ‘지도’가 됩니다. 데이터가 새면 대응 난이도가 급상승합니다.
Q3. 접근 통제를 RBAC로만 해도 충분할까요?
- 초기에는 가능하지만, 데이터가 커지고 팀이 늘면 RBAC만으로는 구멍이 생깁니다. 최소한 디바이스 조건, 시간/위치 조건, 다운로드 제한 같은 정책 기반 요소를 추가해야 실제 유출을 막을 수 있습니다.
Q4. 잘못 마스킹해서 분석/학습이 깨지면 원복(롤백)은 어떻게 하나요?
- 마스킹/토큰화는 반드시 버전 관리 + 즉시 원복 루틴이 있어야 합니다.
- (1) 변경 전/후 샘플 검증(필수 피처 유지 여부)
- (2) 문제 발생 시 이전 버전 정책으로 되돌리기
- (3) 재학습/재산출 범위를 명확히 해서 데이터 정합성을 회복
이 3단계가 없으면 “보호 강화”가 곧 “서비스 중단”으로 이어질 수 있습니다.
Q5. 로그를 많이 남기면 오히려 보안 리스크가 커지지 않나요?
- 맞습니다. 그래서 감사 로그는 “많이”가 아니라 필요한 이벤트를 높은 품질로 남겨야 합니다. 접근/다운로드/권한 변경 같은 핵심 이벤트를 중심으로, 보존 기간과 파기 정책을 함께 설계하면 리스크를 줄일 수 있습니다.
– 마무리: 모델보다 데이터가 더 중요하다
예측형 보안의 성능은 결국 데이터에서 나오고,
그 데이터가 새면 성능보다 더 큰 문제가 됩니다.
암호화(저장/전송) → 접근 통제(정책 기반) → 로그 관리(감사/파기)를 절차로 고정하면,
예측형 보안은 “똑똑한 시스템”을 넘어 “안전한 시스템”이 됩니다.