목차
AI 데이터 거버넌스 구축 전략과 관리 모델
AI 성과는 알고리즘보다 데이터 운영 능력에 의해 더 크게 좌우됩니다.
AI 데이터 거버넌스는 단순한 규칙 묶음이 아니라,
신뢰성과 법적 책임을 지탱하는 기술·조직·정책의 결합 모델입니다.
데이터가 추적되지 않으면, AI도 신뢰될 수 없습니다.
AI 데이터 거버넌스는 데이터의 품질, 출처 추적, 접근 통제, 편향 관리,
변경 이력을 전사 운영 프로세스로 묶어 AI 결과의 신뢰성과 책임성을 보장하는 관리 모델입니다.
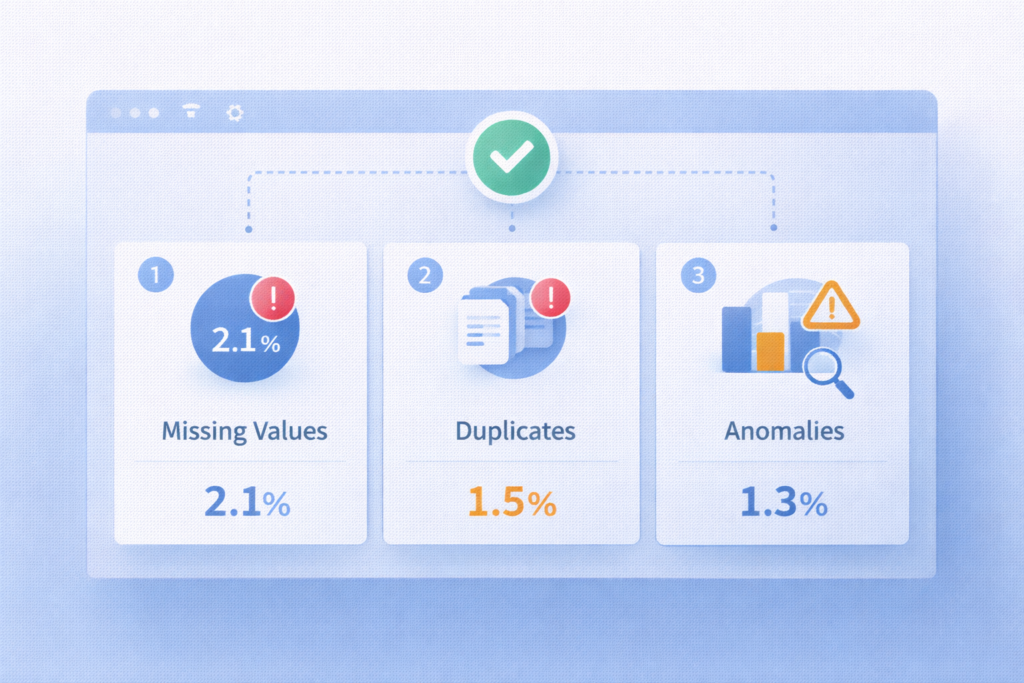
– 핵심 구성 ① 데이터 품질 자동 검증 체계
AI 운영에서 ‘품질’은 감으로 판단하면 실패합니다.
정량 기준과 자동화가 필요합니다.
- 결측/중복/이상치 자동 탐지
- 스키마 변경 감지
- 품질 점수와 임계치(경고 기준) 운영
간단한 예시(인라인):
| if missing_rate > 0.02: alert(“quality_gate”) |
– 핵심 구성 ② 출처·가공 기록의 투명성 확보
데이터 신뢰는 “이 데이터가 어디서 왔는가”에서 시작합니다.
- 데이터 계보(라인리지) 관리
- 라벨링 기준과 변경 이력
- 버전 관리(학습 데이터/피처/샘플)
이 영역은 ISO 관점의 문서화와도 연결됩니다.
– 핵심 구성 ③ 편향 탐지와 재학습 프로세스
편향은 한 번 잡고 끝나는 문제가 아닙니다.
운영 중 데이터 분포가 바뀌면 다시 생깁니다.
- 집단별 성능 편차 모니터링
- 데이터 분포 변화 감지(드리프트)
- 재학습 트리거와 승인 절차
여기서 NIST 같은 위험관리 접근이 자주 참고됩니다.
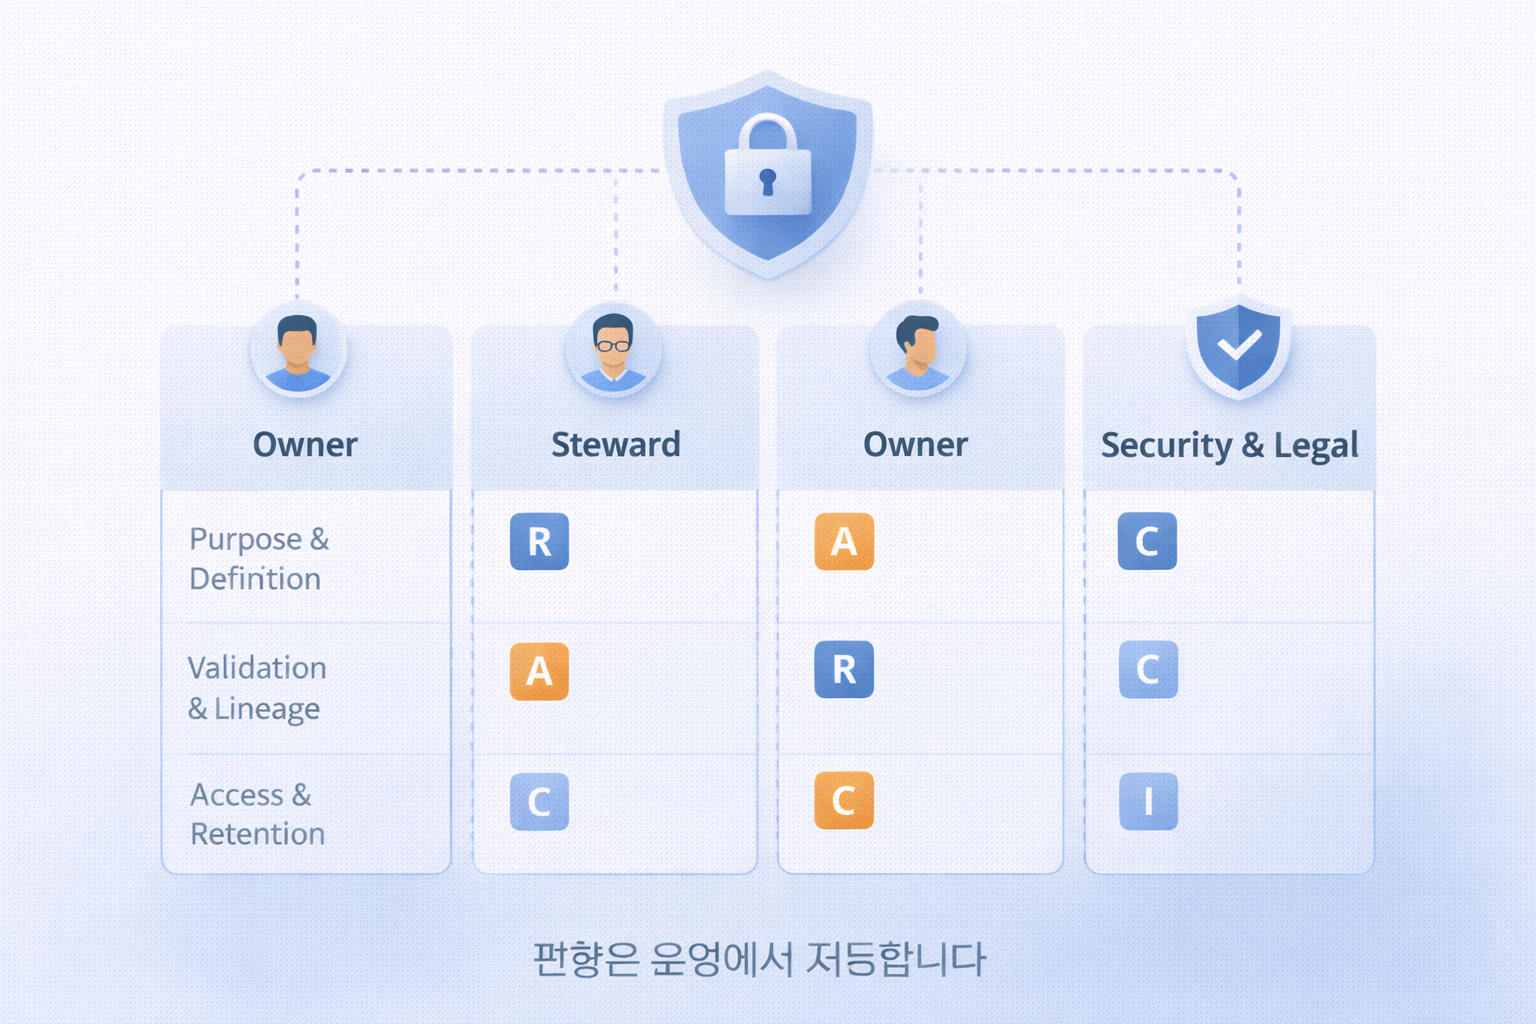
– 전략 포인트 ① 내부 데이터 윤리·책임 역할을 세운다
거버넌스는 “누가 책임지나”가 정해져야 작동합니다.
- 데이터 오너: 목적·정의 승인
- 스튜어드: 품질·표준 운영
- 보안/법무: 접근·보관·감사 기준
특히 AI는 판단 결과가 업무에 영향을 주므로 책임 구조가 더 중요합니다.
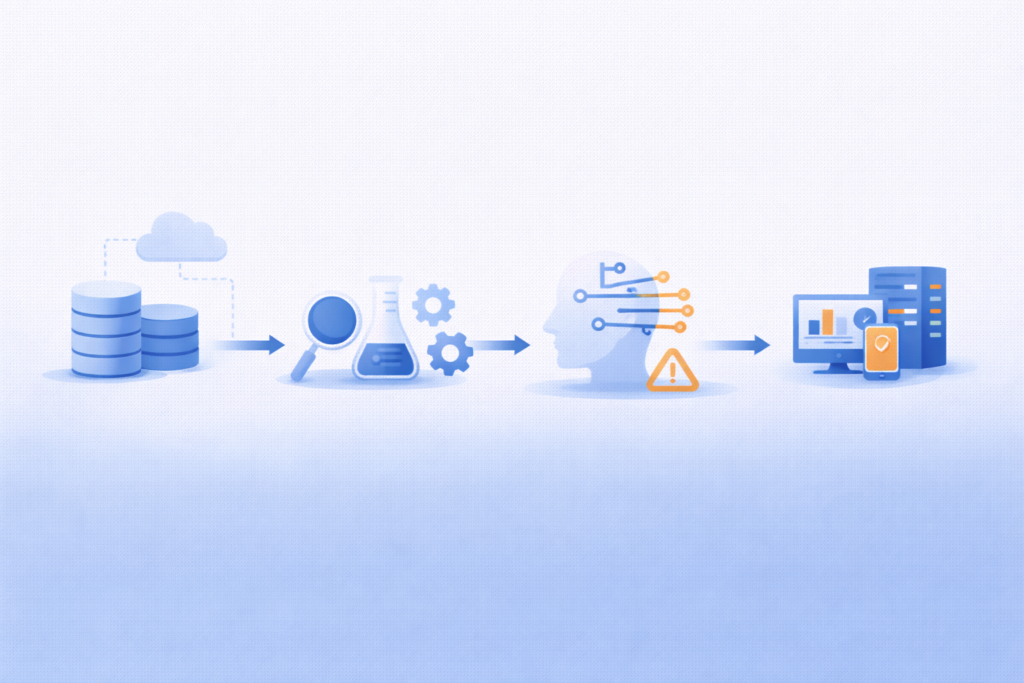
– 전략 포인트 ② 라벨링·버전·정책을 함께 묶는다
AI 조직이 커질수록 혼선이 생깁니다.
라벨링, 버전, 정책이 따로 놀면 운영 비용이 급증합니다.
- 라벨링 지침 표준화
- 데이터셋/피처 버전 일관화
- 정책 자동 배포(권한/보관/마스킹)
이 조합이 되어야 확장 가능한 운영이 됩니다.
– 마무리
AI를 도입한 뒤 문제가 생겼을 때,
결국 확인하는 건 데이터의 출처와 운영 기록입니다.
AI 데이터 거버넌스는 그 순간 조직을 지켜주는 안전장치이자,
AI를 “규모 있게” 굴리기 위한 인프라입니다.
*요약*
– AI 데이터 거버넌스는 신뢰성과 책임을 위한 운영 체계입니다.
– 품질 자동 검증, 출처 추적, 편향 관리가 핵심 축입니다.
– 조직 역할과 버전·정책 통합이 확장성을 만듭니다.
*FAQ*
Q1. AI 데이터 거버넌스 구축의 1순위는 무엇인가요?
A. 데이터 정의(메타데이터)와 출처 추적부터 잡는 게 가장 빠릅니다.
Q2. 품질 자동 검증은 어떤 지표로 시작하나요?
A. 결측률, 중복률, 이상치 비율, 스키마 변경 감지부터 권장합니다.
Q3. 편향 관리는 누가 책임져야 하나요?
A. 현업(목적)·데이터(품질)·보안/법무(통제)가 역할을 나눠야 합니다.