목차
“자율화는 설계로 만든다”
AI 운영 자동화의 핵심 목표는 “사람을 빼는 것”이 아니라 운영의 자율화(Self-Optimization)입니다.
즉, 예측·판단·수정이 흐름으로 이어지고, KPI로 스스로 보정되는 구조죠.
다만 자동화가 커질수록 실패도 커지기 때문에, 한계선을 설계하는 전략이 필요합니다.
– AI 예측 + RPA 실행 + KPI 피드백이 기본 골격입니다.
– 한계는 “데이터/권한/책임”에서 발생합니다.
– 확장은 “예외·감사·롤백”을 먼저 깔아야 안전합니다.
AI 운영 자동화는 Observability 데이터(메트릭·로그·트레이스)와 운영 정책을 기반으로
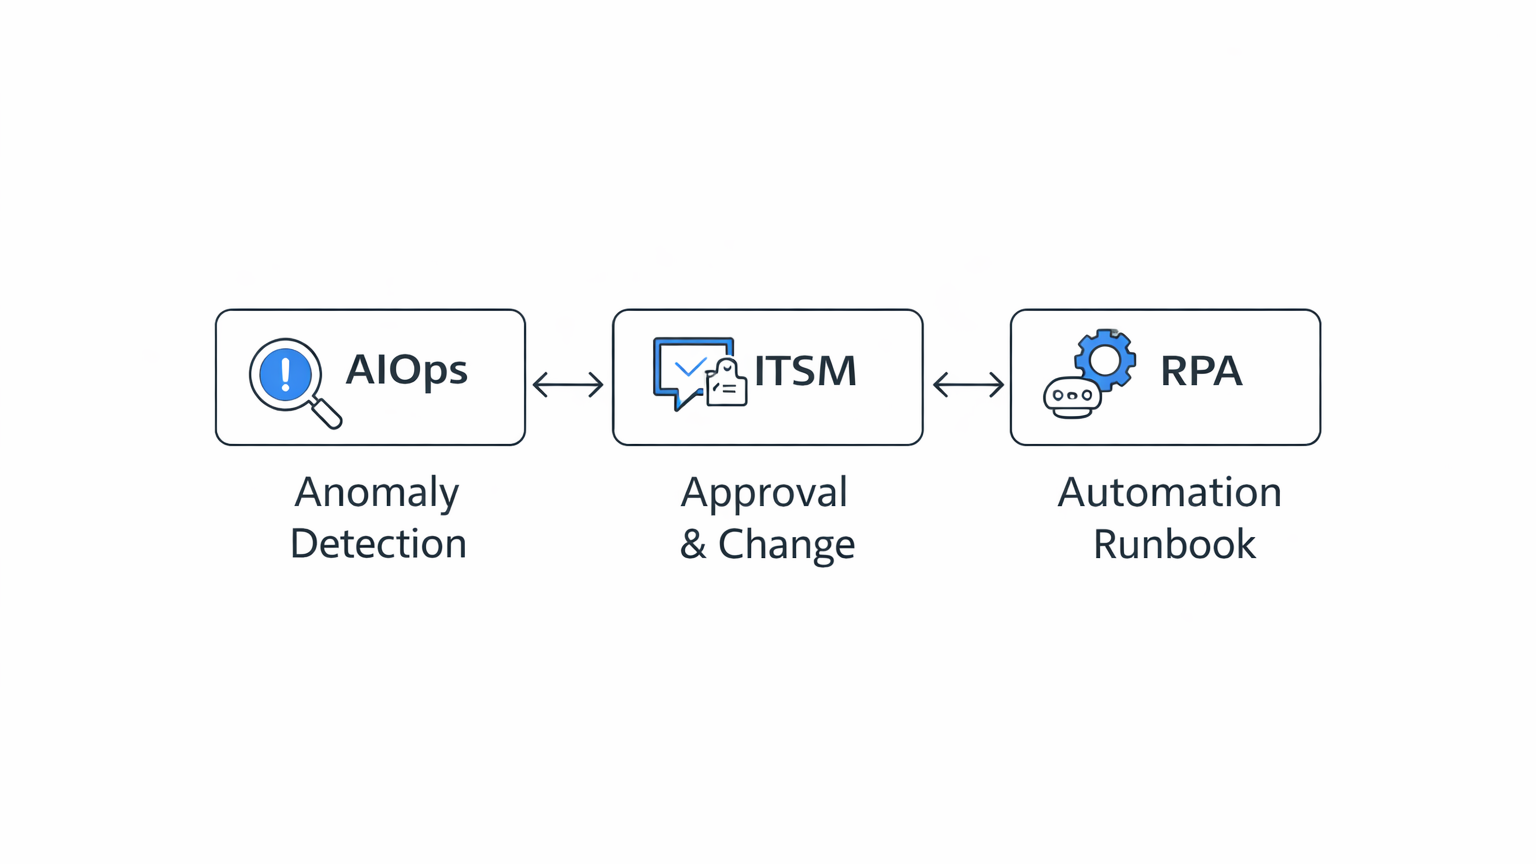
이상 탐지와 원인 추정을 수행하고, ITSM 변경·승인 프로세스와 RPA 실행을 연결해 조치를 자동화하며,
KPI 피드백 루프로 지속적으로 규칙과 모델을 보정하는 운영 아키텍처입니다.
*오늘 얻을 것/목표*
– “자동화가 실패하는 지점”을 미리 식별하는 3가지 한계
– 실행 전략 3종(모델+RPA / 규칙 기반 / KPI 피드백 루프) 확장 방법
– 사례(비용 절감, 장애 예측/자동 복구)를 재현 가능한 형태로 쪼개기
*바로 적용: 핵심 실행 한 줄*
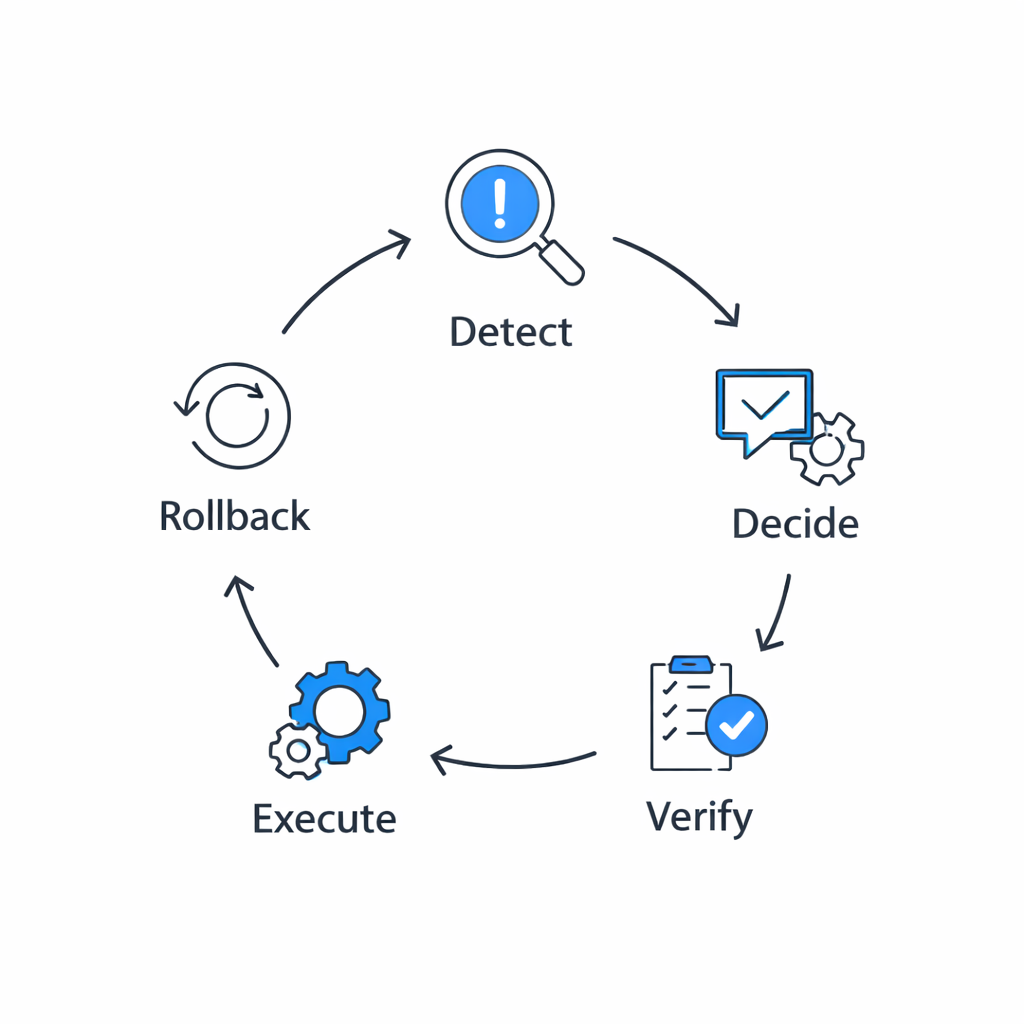
– 자동화는 “탐지→결정→실행→검증→롤백” 5단계를 한 세트로 설계하세요.
*읽고 나면 달라지는 점*
– 자동화의 범위를 ‘감’이 아니라, 데이터·권한·책임 기준으로 확장할 수 있습니다.
– 자동화의 한계는 데이터 품질과 관측 범위에서 시작됩니다
- 브리지: AI가 못하는 게 아니라, 보지 못하면 못합니다.
- Observability가 빈약하면(로그 누락, 추적 불가) 원인 추정이 흔들립니다.
- 라벨/정답 데이터가 부족하면 예측 모델은 오탐을 늘립니다.
- 대응: “중요 서비스부터” 메트릭/로그/트레이스 표준을 정하고, SLO/SLA 기준을 먼저 걸어두세요.
– 실행 전략 1 : AI 예측 모델과 RPA를 결합해 ‘닫힌 루프’를 만듭니다
- 브리지: 예측은 ‘추천’이고, 실행은 ‘변화’입니다. 둘을 붙여야 효과가 납니다.
- 흐름: 이상 탐지(AIOps) → 티켓 생성(ITSM) → 표준 런북 실행(RPA) → 결과 검증
- 운영 포인트: 실행 전후 스냅샷과 롤백 절차를 자동화에 포함
- 간단 예시(개념 코드)
| if anomaly_score(service) > 0.92 and change_window_ok(): create_ticket(itsm=”ServiceNow”, severity=”P2″) run_runbook(“restart-canary”, platform=”Kubernetes”) verify_slo(target=”latency_p95″, max_ms=250) else: route_to_human(oncall=True) |
– 실행 전략 2 : 자동화 규칙 기반 운영 프로세스로 안정성을 먼저 확보합니다
- 브리지: “모델”이 불안정하면, “규칙”이 안전망이 됩니다.
- 정책: 변경 승인(ITSM), 배포 제한(릴리즈 가드), 자동 조치 횟수 제한(서킷 브레이커)
- 권한: 자동화 계정 권한은 최소화(Principle of Least Privilege)
- 감사: 누가/언제/근거/결과를 남기는 감사 로그는 SOC2 같은 컴플라이언스 대응에도 도움이 됩니다.
– 실행 전략 3: KPI 기반 자동 피드백 루프로 ‘Self-Optimization’에 접근합니다
- 브리지: 자율화는 “한 번 잘 돌리는 것”이 아니라, “계속 더 좋아지는 것”입니다.
- KPI 예시: MTTR, 변경 실패율, 알림 노이즈 비율, 인프라 비용(FinOps)
- 피드백: KPI 악화 시 규칙 강화, 모델 임계치 조정, 런북 수정
- 운영 팁: “사람 검토 단계”를 주기적으로 넣어 드리프트(환경 변화)로 인한 오류를 막으세요.
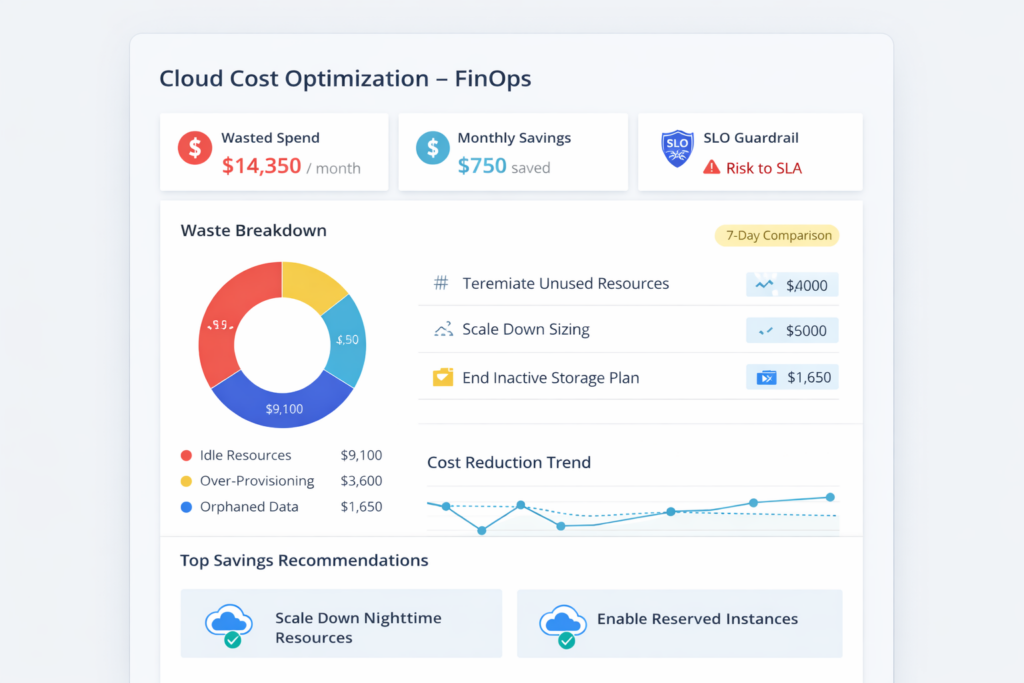
– 적용 사례 1: 클라우드 자원 비용 절감은 FinOps와 붙이면 빨라집니다
- 브리지: 비용은 ‘사용량’이 아니라 ‘낭비’를 줄이는 게임입니다.
- 예: 야간 스케일 다운, 미사용 리소스 정리, 예약 인스턴스/세이빙 플랜 추천
- 주의: 자동 축소는 성능(SLA)과 충돌할 수 있어, SLO 가드레일이 필수입니다.
– 적용 사례 2: 장애 예측 및 자동 복구는 “표준화된 런북”이 성패를 가릅니다
- 브리지: 자동 복구는 기술보다 운영 표준이 먼저입니다.
- 예: 지연시간 급등 → 카나리 재배포 → 특정 노드 격리 → 정상화 검증
- 검증: 복구 뒤 “원인/재발 방지”까지 연결되어야 진짜 자동화입니다.
– 마무리
운영 자율화는 멋진 목표지만, 자동화가 커질수록 “작은 오류”가 “큰 사고”가 됩니다.
그래서 확장 전략의 순서는 단순합니다.
관측(Observability) → 안전장치(예외·감사·롤백) → 실행 자동화(RPA) → KPI 피드백 루프.
이 순서대로 쌓으면, 자동화는 리스크가 아니라 경쟁력이 됩니다.
*요약*
– AI 운영 자동화는 모델·규칙·KPI 루프의 조합으로 확장됩니다.
– 한계는 데이터/권한/책임에서 생기며, 예외·감사·롤백이 안전장치입니다.
– 비용 절감과 자동 복구는 “가드레일(SLA/SLO)”을 먼저 깔 때 성과가 재현됩니다.
*FAQ*
Q1. 운영 자율화(Self-Optimization)와 단순 자동화의 차이는 뭔가요?
A. 단순 자동화는 작업을 줄이고, 자율화는 KPI 피드백으로 규칙/모델이 계속 보정되는 “닫힌 루프”를 만듭니다.
Q2. AI 예측이 오탐이 많으면 어떻게 해야 하나요?
A. 관측 데이터 품질을 먼저 개선하고, 임계치 조정·규칙 가드레일·사람 승인 단계를 두어 위험을 제한하세요.
Q3. 자동 복구를 도입할 때 가장 중요한 1가지는요?
A. 표준 런북과 롤백 절차입니다. “실행 후 검증”까지 포함해야 안전하게 확장됩니다.