목차
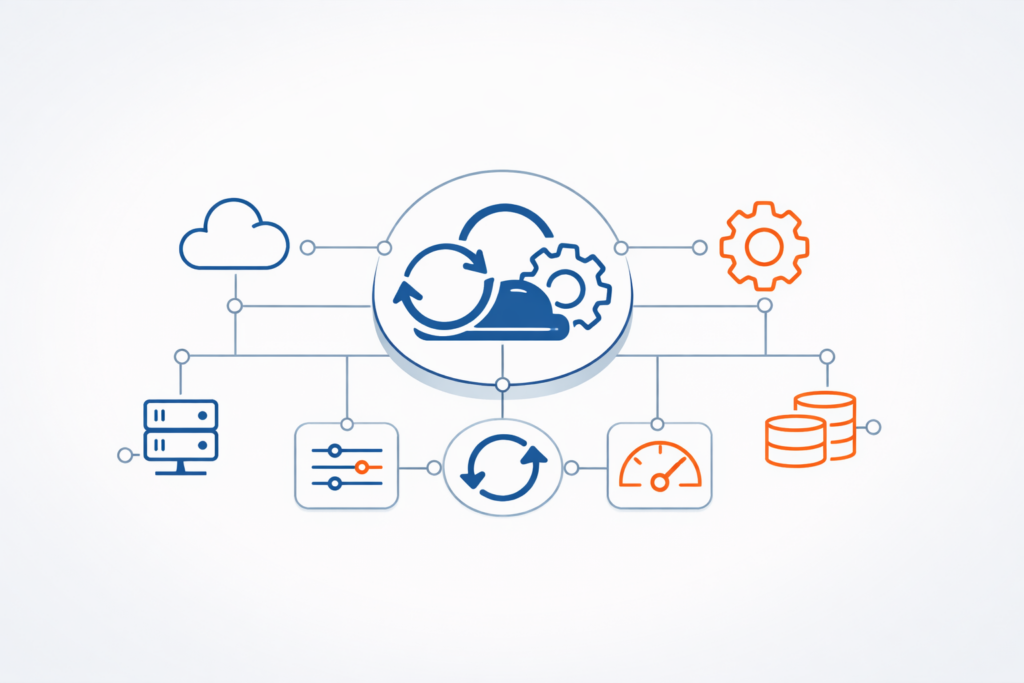
AI 워크로드는 실험→학습→배포→모니터링→재학습의 순환이 빠르고,
인프라/데이터/보안/비용이 동시에 움직입니다. 이 구조에서 사람 손으로 운영을 붙잡고 있으면,
“속도는 느려지고 사고는 늘고 비용은 새는” 전형적인 패턴이 반복됩니다.
이번 글은 개념 → 구축 단계별 절차 → 자동화 이후 최적화 루틴 흐름으로, 팀이 바로 로드맵을 그릴 수 있게 정리합니다.
– AI 인프라 자동화란 무엇인가
AI 인프라 자동화는 모델 학습/추론을 받쳐주는
컴퓨팅·스토리지·네트워크·배포·관측·보안 정책을 코드와 워크플로로 표준화해,
반복 작업을 줄이고 안정적으로 확장하는 접근입니다.
핵심은 “도구 도입”이 아니라 아래 3가지를 동시에 달성하는 것입니다.
- 재현성: 같은 입력이면 같은 환경이 만들어짐(환경 편차 제거)
- 속도: 실험/배포 사이클을 단축(릴리즈 리드타임 감소)
- 안전성: 권한·정책·감사·롤백이 체계화(사고 반경 최소화)
– 왜 지금 자동화가 필요한가: 현장에서 터지는 원인들
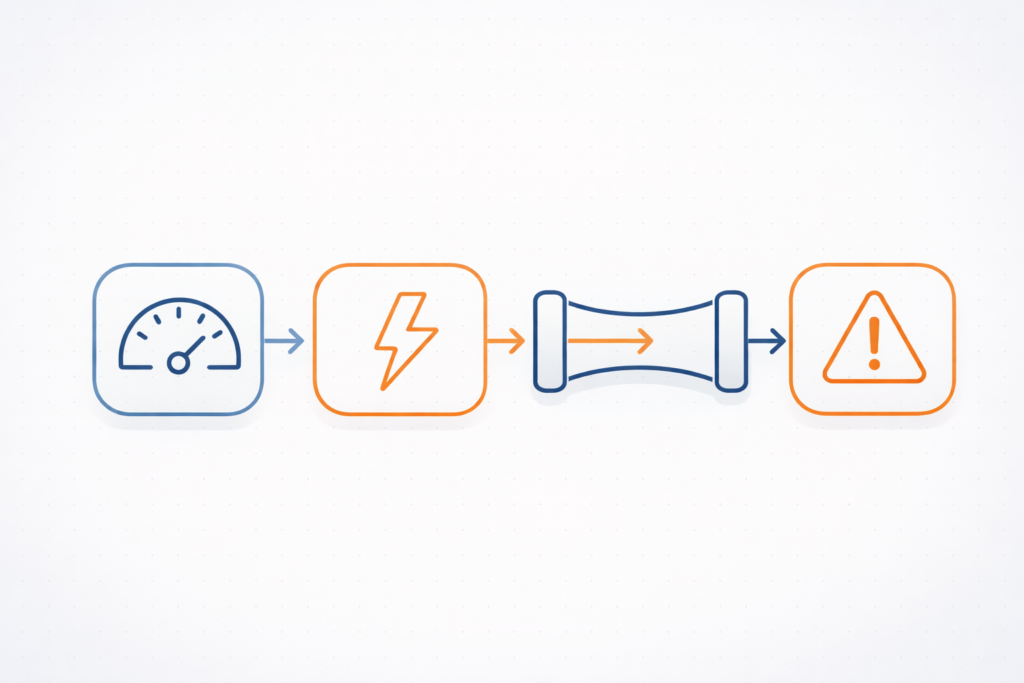
AI 인프라가 커질수록 “운영 병목”은 더 빨리 드러납니다. 흔한 원인은 이렇습니다.
- 환경이 늘어날수록 사람의 기억에 의존: “누가 언제 뭘 바꿨지?”가 상시 발생
- 실험 속도와 운영 속도의 불일치: 연구/데이터팀은 빨리 돌리는데, 인프라 반영은 느림
- 변경이 누적될수록 리스크 증가: 작은 변경이 연쇄 장애로 번짐(관측/가드레일 부족)
- 비용 통제 실패: GPU/스토리지 사용량이 눈덩이처럼 불어나도 기준선이 없음
- 보안·규정 대응이 뒤로 밀림: 계정/권한/비밀관리/감사가 “나중에”로 취급됨
이 문제들은 “더 열심히”가 아니라,
표준(코드) + 자동 실행(파이프라인) + 관측(루틴)으로만 구조적으로 줄어듭니다.
– 구축 단계별 절차: 자동화는 ‘순서’가 성패를 가른다
아래 순서대로 가면, 중간에 흔히 발생하는 “자동화 도입했는데 더 복잡해짐”을 피하기 좋습니다.
1) 현황 진단: 자동화 대상부터 정확히 자르기
- 운영 업무를 반복/수동/긴급/실수 잦음 기준으로 목록화
- 장애/지연/비용 이슈를 “원인-영향-빈도”로 분류
- 자동화 목표를 숫자로 박기
예) 배포 리드타임 50% 단축, 변경 실패율 30% 감소, GPU 유휴율 20% 개선
2) 표준 설계: ‘한 번 정하면 계속 쓰는’ 기준 만들기
- 환경 템플릿(Dev/Stage/Prod), 네트워크/권한 경계, 네이밍 규칙
- 모델/데이터 파이프라인이 요구하는 리소스 프로파일(GPU 타입, 스토리지, 캐시, 네트워크)
- 운영 원칙: 승인 흐름, 변경 창, 롤백 기준, 온콜/에스컬레이션
3) 코드화(IaC): 인프라를 “클릭”이 아니라 “코드”로
- VPC/서브넷/보안그룹/클러스터/스토리지/레지스트리 등 기반을 코드로 고정
- 모듈화: 팀/서비스 단위로 재사용 가능하게 구성
- 상태/드리프트 관리(의도와 실제 인프라가 어긋나는 문제) 포함
4) 배포 자동화(CI/CD + Git 기반 운영): 변경을 안전하게 흘려보내기
- 변경은 PR로 들어오고, 리뷰/정책 체크 후 머지되면 자동 반영
- “누가/왜/무엇을” 바꿨는지 추적 가능한 기록 체계
- 배포 전략: 블루-그린/카나리/점진 롤아웃, 실패 시 자동 중단
5) 관측 자동화(Observability): 자동화의 다음 단계는 ‘자동 감지’
- 지표/로그/트레이싱을 표준 스키마로 통일
- SLI/SLO 기반으로 알림 품질 개선(알림 폭주 방지)
- 비용 지표(리소스 단가, GPU 사용률, 스토리지 증가율)도 운영 대시보드에 포함
6) 보안·거버넌스: “나중에”가 가장 비싼 영역
- 최소권한(역할 기반), 비밀관리(키/토큰/인증서), 감사로그 기본값화
- 정책을 코드로(허용 리전, 퍼블릭 노출 금지, 암호화 강제 등)
- 운영 권한은 사람에게 상주시키지 말고, 파이프라인과 정책에 위임
7) 점진 확장: 한 번에 다 하려다 실패하지 않기
- 1~2개 핵심 서비스/파이프라인부터 “표준 성공 사례” 만들기
- 템플릿/모듈로 확장하면서 팀 간 편차를 줄이기
- 운영 루틴을 문서가 아니라 자동 체크로 바꾸기
– 자동화 이후 최적화 루틴: “한 번 만들고 끝”이 아니다
자동화는 시작점이고, 효율성은 루틴에서 만들어집니다.
아래 루틴을 주간/월간으로 굴리면 체감이 빠릅니다.
주간 루틴(운영 안정화)
- 변경 실패/롤백 건수, 평균 복구시간, 알림 품질(유효 알림 비율) 점검
- 드리프트 감지 리포트 확인 및 원인 제거
- 비용 이상치 탐지(급증 리소스, 유휴 GPU/노드) → 원인별 조치
월간 루틴(성능·비용 최적화)
- 리소스 프로파일 업데이트(워크로드별 GPU/메모리/스토리지 표준 재조정)
- 캐시/스토리지 계층화 정책 점검(콜드 데이터 이동, 수명주기 정책)
- 보안 점검 자동화 결과 리뷰(권한 과다, 미사용 키, 공개 엔드포인트)
분기 루틴(회복탄력성 강화)
- 장애 리허설(게임데이), 복구 시나리오 리빌드(“문서대로 되나?” 검증)
- 운영 자동화의 사각지대(여전히 사람 손이 필요한 작업) 제거
- 로드맵 재정렬: “가장 아픈 곳”부터 다시 우선순위 조정
– 체크리스트: 지금 우리 팀은 어디부터 시작해야 하나
- 반복 업무(배포/권한/환경 생성/모니터링 설정)를 목록화했다
- 표준 템플릿(환경/네이밍/권한/네트워크)을 합의했다
- 인프라가 코드로 재현 가능하다(IaC)
- 변경이 PR 기반으로 기록/승인/자동 반영된다
- 관측(지표/로그/트레이싱)과 비용 지표가 한 화면에서 보인다
- 보안/정책이 “규정 문서”가 아니라 “자동 체크”로 동작한다
- 실패 시 원복(롤백/복구)이 절차가 아니라 실행 가능한 루틴이다
– FAQ
Q1. AI 인프라 자동화는 IaC만 도입하면 끝인가요?
아니요. IaC는 “만드는 방식”을 표준화하는 시작점이고, 실제 효과는 변경 흐름(리뷰/정책/배포)과 관측/비용/보안 루틴까지 연결될 때 크게 납니다.
Q2. 자동화가 안되면(도입이 막히면) 어디부터 줄여야 하나요?
가장 작은 단위로 쪼개세요.
“환경 생성” 한 가지부터 템플릿화 → 다음으로 “배포” → 다음으로 “관측 설정”
그리고 팀 공통 표준(네이밍/권한/네트워크)부터 먼저 합의하면, 도구 갈등이 줄어듭니다.
Q3. 리스크는 뭐가 가장 큰가요?
가장 흔한 리스크는 자동화가 ‘우회 가능한 선택지’로 남는 것입니다. 일부만 자동화하고 나머지는 수동이면, 결국 운영 지식이 분산되고 사고 대응이 느려집니다.
두 번째는 권한/비밀관리를 뒤로 미루는 것입니다. 이건 사고 비용이 크게 튑니다.
Q4. 원복(롤백/복구)은 어떻게 설계해야 하나요?
원복은 “문서”가 아니라 버튼/명령으로 재현 가능한 실행 흐름이어야 합니다.
변경 전 상태를 되돌리는 경로(인프라/배포/설정)
데이터/모델 아티팩트의 버전 관리
복구 리허설(정기 게임데이)
이 3가지가 같이 있어야 실제로 원복이 됩니다.
Q5. 자동화 이후에도 사람이 해야 할 일은 남나요?
남습니다. 다만 “반복 실행자”가 아니라 정책 설계자·품질 관리자로 역할이 바뀝니다. 자동화의 목표는 사람을 빼는 게 아니라, 사람이 해야 할 일을 더 고급화하는 데 있습니다.
– 마무리: 현황 진단 후 자동화 도입 로드맵 설정
AI 인프라 자동화는 유행어가 아니라, 속도·안정성·비용·보안을 동시에 잡기 위한 운영 체계입니다.
오늘 할 일은 단순합니다. 현황을 진단하고(어디가 반복/병목인지), 단계별로 자동화 로드맵을 설정하세요.
한 번에 완벽하려 하지 말고, “작게 성공 → 표준화 → 확장” 루프로 가면 빠르게 체감할 수 있습니다.