
목차
“관리 자동화 도입 전 점검이 성패를 좌우한다”
장비 목록화 → 자동화 범위 설정 → 테스트 시나리오 검증만 지켜도, 운영 장애율은 눈에 띄게 줄어든다.
“관리 자동화 도입 전 점검이 성패를 좌우한다”를 먼저 고정해야 한다
정의: AI 장비 관리 자동화는 GPU 서버·워크스테이션·엣지 디바이스 등
운영 자산의 상태/변경/권한을 정책으로 표준화하고,
반복 작업을 워크플로우로 실행되게 만드는 운영 체계다.
현실에서는 장비가 10대에서 50대로 늘어나는 순간, “누가 마지막으로 드라이버를 올렸는지”,
“어느 노드가 과열로 쓰로틀링 중인지”가 기록에서 빠지기 시작한다.
장비 한 대의 작은 설정 차이가 학습 실패나 배포 장애로 번지고, 야간 호출이 생긴다.
특히 장비가 자주 바뀌는 팀이라면, 자동화 도입 전에 기준을 잡지 않으면 운영이 더 복잡해진다.
– 장비가 늘수록 ‘소유·상태·변경’이 흐려진다
AI 장비 운영에서 가장 먼저 무너지는 건 기술이 아니라 가시성이다.
- 장비 소유가 불명확하면 “수리/교체 승인”이 지연된다.
- 상태 수집이 느슨하면 “성능 저하 원인(온도/메모리/드라이버)”이 뒤늦게 드러난다.
- 변경 기록이 없으면 “어제는 되던 학습이 오늘은 실패” 같은 재현 불가 사건이 쌓인다.
이 세 가지가 겹치면 운영은 사람 의존으로 바뀌고, 자동화는 “스크립트 모음”에서 끝난다.
– 장애는 ‘반복 작업’이 아니라 ‘예외 처리’에서 터진다
운영 장애는 정상 시나리오보다 예외 시나리오에서 발생한다. 대표 패턴은 다음 4가지로 수렴한다.
1. 환경 불일치: 동일 모델 GPU인데 드라이버/CUDA가 다르다
2. 권한 혼선: 누군가는 root, 누군가는 sudo 불가로 작업 경로가 갈라진다
3. 모니터링 공백: 온도·팬·디스크·ECC 에러가 누락된다
4. 업데이트 충돌: 보안 패치/커널 업데이트가 런타임과 충돌한다
자동화 체크는 “정상 흐름을 빠르게”가 아니라 예외가 생겨도 운영이 흔들리지 않게 만드는 데 초점을 둬야 한다.
– 자동화 실패는 ‘도구’가 아니라 ‘기준 부재’에서 시작된다
자동화가 실패하는 이유는 한 가지로 정리된다.
기준이 없는데 실행만 자동화하기 때문이다.
첫째, 목록이 부정확하면 자동화는 잘못된 타깃에 실행된다.
IP가 바뀐 장비, 폐기된 노드, 교체된 디스크를 그대로 밀어버린다.
둘째, 범위가 불명확하면 운영팀은 “자동화가 어디까지 책임지는지” 합의하지 못한다.
그 결과 사람 작업과 자동화가 섞여 기록이 찢어진다.
또 하나의 Why가 있다. AI 장비는 ‘성능’이 곧 ‘서비스 품질’이라서,
운영 기준이 흔들리면 비용이 즉시 증가한다.
같은 학습이 10시간에서 14시간으로 늘어나면 GPU 비용과 일정이 동시에 늘어난다.
결국 자동화 도입은 “편의”가 아니라 표준 운영을 강제해 장애율과 변동비를 낮추는 프로젝트로 봐야 한다.
– 수동 관리 vs 자동화 관리의 차이는 ‘가시성·재현성’이다
| 구분 | 수동 관리(사람 중심) | 자동화 관리(정책 중심) | 도입 판단 기준 |
|---|---|---|---|
| 자산 파악 | 엑셀/메신저 업데이트 | CMDB/인벤토리 단일화 | “누가 봐도 같은 목록” |
| 변경 기록 | 기억/일부 티켓 | 변경 이력 자동 기록 | “실패 재현 가능” |
| 상태 수집 | 장애 후 확인 | 상시 모니터링/알림 | “장애 전 징후 탐지” |
| 권한/접근 | 예외적 root | RBAC/승인 흐름 | “권한=정책” |
| 배포/업데이트 | 장비별 수동 | 롤링/승인/롤백 | “실패 시 즉시 복구” |
판단은 간단하다. 가시성과 재현성이 올라가면 성공, “빨라졌는데 이유를 모르면” 실패다.
– 1) 장비 목록화 → 2) 자동화 범위 설정 → 3) 테스트 시나리오로 검증해야 한다
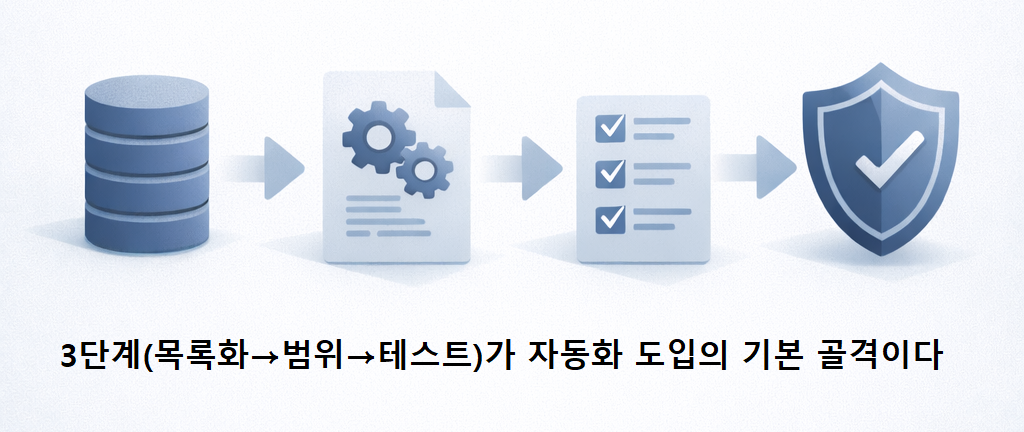
1) 장비 목록화: ‘운영 가능한 단일 진실’을 만들어야 한다
목록화는 “몇 대인지”가 아니라 운영 판단 필드가 채워졌는지가 핵심이다.
- 장비 ID / 위치 / 담당 팀
- CPU·RAM·GPU 모델·수량 / 드라이버·CUDA 버전
- OS·커널 버전 / 스토리지 / 네트워크(고정 IP 여부)
- 모니터링 설치 여부 / 알림 채널 / 보증·교체 주기
- 접근 정책(SSH/VPN/bastion) / 권한 모델(RBAC 기준)
산출물 : 장비 인벤토리 표 + 업데이트 규칙(누가/언제/어떻게 갱신)
2) 자동화 범위 설정: ‘자동화의 책임 경계’를 문서로 박아야 한다
범위는 3영역으로 나누고 “자동/수동/승인 필요”를 분리한다.
- 프로비저닝: OS 초기화, 기본 패키지, 계정/키 배포
- 운영 유지: 드라이버/CUDA 표준 적용, 보안 패치, 설정 동기화
- 관측/대응: 상태 수집(온도/ECC/디스크), 임계치 알림, 장애 격리
원칙은 단정하면 끝난다.
- 고위험(커널/드라이버 교체) = 승인 + 롤링
- 반복(계정/키/모니터링) = 완전 자동
- 예외 = Allowlist로 관리
3) 테스트 시나리오: ‘성공’이 아니라 ‘실패 안전’을 증명해야 한다
테스트는 기능이 아니라 운영 시나리오로 작성한다.
1. 신규 장비 1대 추가(프로비저닝)
2. 드라이버 표준 적용(롤링)
3. 커널 업데이트 충돌(실패 처리)
4. GPU 과열(알림 + 작업 중단/격리)
5. 디스크 불량 감지(ECC/SMART)
6. 권한 오남용 시도(RBAC 차단 + 감사 로그)
– 30초 체크 – 도입 전 ‘5줄’만 확인해도 리스크가 줄어든다
아래 5개 중 3개 이상이 ‘아니오’면 도입을 멈추고 목록/범위를 먼저 정리한다.
- 인벤토리에 GPU/드라이버/CUDA/커널이 기록되어 있다
- 자동화 vs 사람 작업 경계 문서가 있다
- RBAC + 감사 로그가 준비되어 있다
- 작업별 롤백 기준이 정의되어 있다
- 테스트 시나리오가 예외 상황 중심이다
– 권한·예외·롤백이 빠지면 자동화가 장애를 만든다
자주 벌어지는 패턴은 이렇다.
드라이버 표준화를 자동화로 일괄 적용했는데,
일부 장비는 특정 커널 모듈과 호환이 맞지 않아 재부팅 루프에 들어간다.
야간 배포가 중단되고, 결국 “자동화가 문제였다”는 결론이 난다.
하지만 원인은 기술이 아니라 3가지다.
1. 예외 목록 부재(특정 모델/커널 제외 조건 없음)
2. 승인/롤링 부재(전체 동시 적용)
3. 롤백 기준 부재(실패 감지 후 복구 루트 없음)
– 운영팀이 바로 쓰는 최소 템플릿(라벨·태그·점검 주기)을 붙여야 한다
도입 첫 달에는 완벽한 플랫폼보다 운영 템플릿 3개가 효과가 크다.
- 라벨/태그 규칙: env=prod|stg, role=train|infer, gpu=A100|H100, driver=xxx
- 점검 주기 규칙: 온도/ECC/디스크=상시, 드라이버/보안=월 1회 승인 배포
- 변경 티켓 규칙: 변경 1건당 “대상/버전/승인자/롤백” 4필드 고정
이 3개가 있으면 도구가 바뀌어도 운영은 유지된다.
– “체계적 점검으로 장애율 감소”로 결론을 닫아야 한다
AI 장비 관리 자동화의 핵심은 도입 전 점검이다.
장비 목록화로 단일 진실을 만들고, 자동화 범위로 책임 경계를 고정하고,
테스트 시나리오로 실패 안전을 검증하면 운영 장애율은 내려간다.
내가 이 상황이라면, 장비가 20대 이상이 되는 시점에
“범위 문서 + 예외 목록 + 실패 테스트”부터 먼저 고정하겠다.
– FAQ
Q1. 장비 목록화는 엑셀로 시작해도 되나?
A. 된다. 단, 필드(드라이버/CUDA/커널/권한/모니터링)와 갱신 규칙(담당·주기)을 고정해야 한다.
Q2. 자동화 범위는 어디까지 잡아야 하나?
A. 계정/키/모니터링 같은 반복 작업은 완전 자동, 커널/드라이버 같은 고위험 작업은 승인+롤링으로 고정한다.
Q3. 테스트 시나리오는 몇 개가 적당한가?
A. 초기엔 10개 내외로 시작하고, 충돌/과열/불량/권한 같은 “예외”를 우선순위로 둔다.
#AI #DeviceOps #Checklist