목차
AI를 운영에 적용하는 논의는 이제 선택의 문제가 아니라
“언제, 어디부터 시작하느냐”의 문제로 바뀌고 있습니다.
AI 운영 자동화는 복잡해지는 클라우드 인프라와 비즈니스 요구 속에서
IT 운영팀이 더 적은 리소스로 더 높은 SLA를 달성하도록 돕는 핵심 레버입니다.
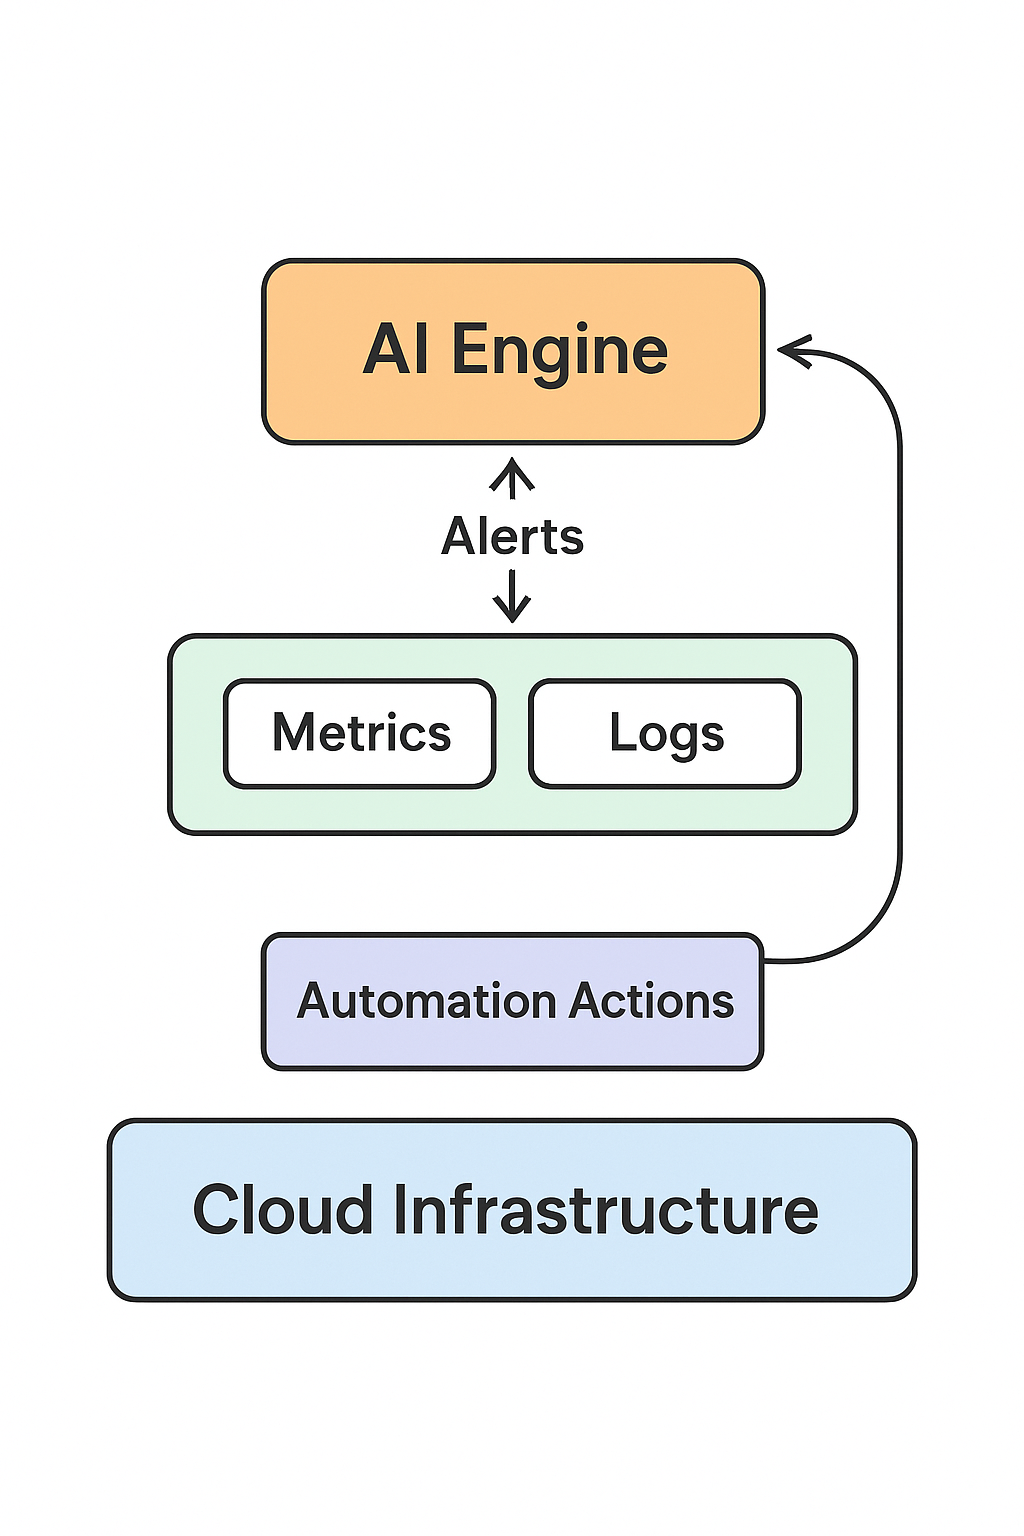
특히 AIOps는 모니터링·로그·티켓 데이터를 통합 분석해 장애 탐지와 자원 최적화를
자동화하는 방식으로 빠르게 확산되고 있습니다.
이 글에서는 AI 운영 자동화의 범위를 AIOps 중심으로 정의하고,
실제 기업 환경에서 적용할 수 있는 핵심 영역과 단계별 전략을 정리합니다.
마지막에는 바로 실행 가능한 첫 파일럿 아이디어도 제안합니다.
실행 한 줄: 현재 모니터링·로그 툴에서 이미 수집 중인 데이터를 기준으로,
“AI가 대신 봐줄 수 있는 영역”과 “사람이 끝까지 책임질 영역”을 먼저 구분해 보세요.
*정의 한 줄(Featured Snippet용)*
AI 운영 자동화는 인프라, 애플리케이션, 네트워크 전반에서 발생하는
방대한 운영 데이터를 AI와 머신러닝으로 분석해 장애 탐지, 원인 진단, 용량 계획, 자동 복구까지
연결하는 접근으로, 단순 스크립트 자동화가 아닌 데이터 기반 의사결정 자동화에 초점을 둔 전략입니다.
*오늘 얻을 것/목표*
AI 운영 자동화의 범위와 가치, 핵심 적용 영역, 단계별 도입 전략, 그리고 파일럿 설계 기준을 한 번에 정리하는 것이 목표입니다.
*바로 적용: 핵심 실행 한 줄*
운영 로그와 모니터링 지표를 “수집 원천–보관 위치–활용 방식” 3단계로 정리하고, 각 단계에 AI를 어디까지 적용할지 설계도를 그려보세요.
*읽고 나면 달라지는 점*
AIOps를 단순 도구가 아닌, 운영 데이터 전략과 조직 역량을 함께 변화시키는 프레임으로 바라보게 될 것입니다.
– AI 운영 자동화의 스코프를 다시 정의하기
첫 단계는 스코프 정의입니다.
모든 운영 업무를 한 번에 자동화하려다가는 실패하기 쉽습니다.
여기서 말하는 AI 운영 자동화는, 모니터링·로그·티켓 시스템에서 나오는
데이터를 ML 모델이 분석하고, 이벤트를 통합·축약하며,
필요 시 조치까지 트리거하는 AIOps 중심 접근으로 한정합니다.
즉, “무엇을 자동화할 것인가?”보다
“어떤 데이터를 기반으로, 어떤 의사결정을 자동화할 것인가?”에 초점을 맞추는 것이 핵심입니다.
– 핵심 자동화 영역 : 인프라, 데이터, 보안
일반적으로 자동화 효익이 큰 영역은 인프라 관리,
데이터 처리, 보안 운영 세 가지입니다.
인프라 관리에서는 장애 예측, 용량 계획,
자가 복구(예: 인스턴스 재기동, 스케일 아웃)가 대표적인 패턴입니다.
데이터 처리 영역에서는 실시간 로그 분석과 이상 탐지,
사용자 행동 패턴 분석이 포함되고,
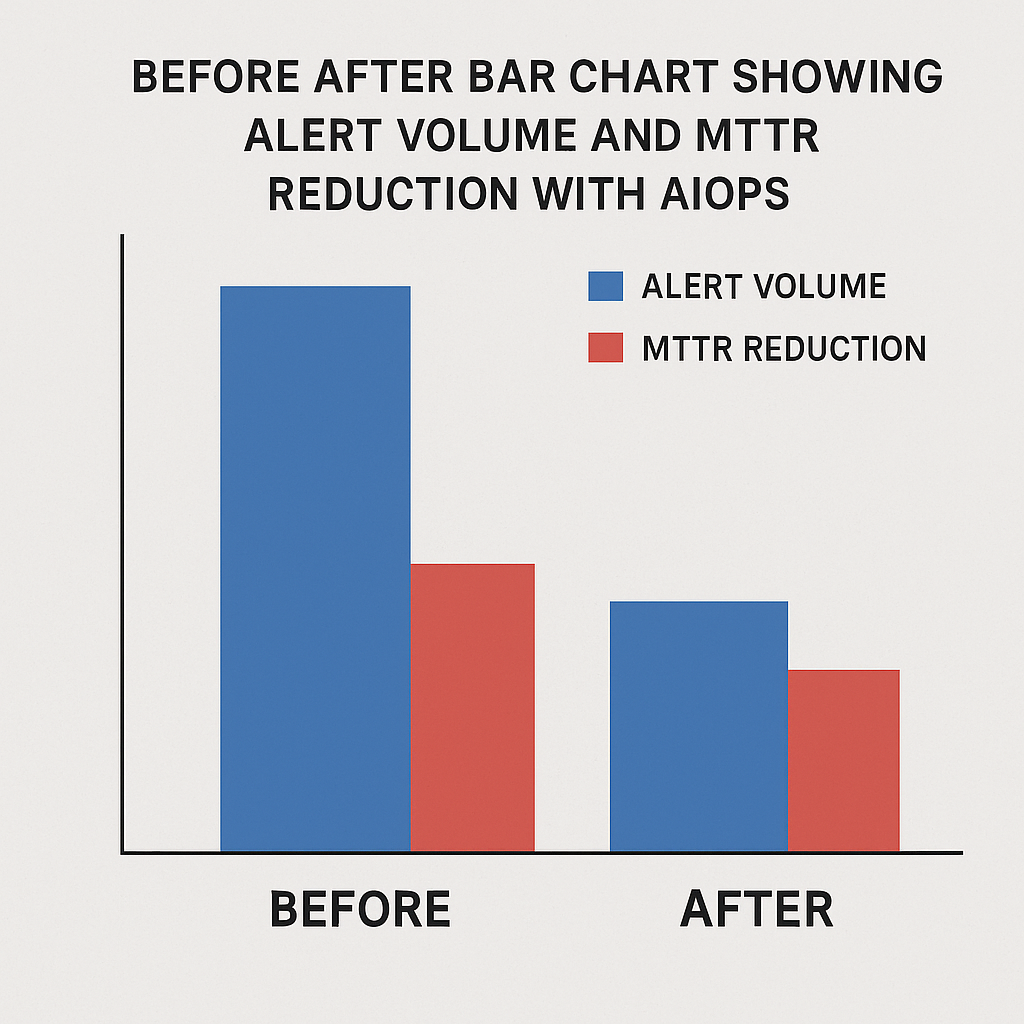
이는 MTTD·MTTR 단축에 직접적으로 기여합니다.
보안 운영에서는 SIEM, SOAR와 연계해 위협 인텔리전스와 플레이북을 자동 실행하는 방식으로,
탐지–분류–조치 흐름을 크게 단축할 수 있습니다.
– 도입 전략 : 데이터 파이프라인이 먼저다
많은 프로젝트가 “어떤 솔루션을 도입할까?”에서 출발하지만,
성공하는 팀은 “데이터 파이프라인을 어떻게 설계할까?”에서 출발합니다.
운영 데이터 소스를 카탈로그 형태로 정리하고,
수집 주기·보존 기간·접근 권한을 명시하면 이후 ML 모델 설계와 거버넌스 수립이 수월해집니다.
이때 DevOps 파이프라인과도 연결해 배포 전·후 메트릭과 로그 변화를 한 흐름으로 볼 수 있게 만들면,
배포 리스크 관리 자동화까지 확장하기 좋습니다.
코드 레벨에서는 예를 들어 if error_rate > threshold: trigger_aiops_alert() 같은
단순 정책에서 시작해, 점차 모델 기반 임계값으로 바꿔가는 식의 점진적 접근이 현실적입니다.
– 운영 모델 : 사람과 AI의 역할 분담 설계
AI 운영 자동화가 잘 작동하려면,
“어디까지 자동으로 실행하고 어디부터는 사람 승인으로 넘길지” 기준이 필요합니다.
예를 들어, 단순 자원 확장은 자동,
데이터 손실 가능성이 있는 조치는 승인 필수 같은 가드레일을 미리 정의해야 합니다.
또한 SRE, 인프라, 보안, 애플리케이션 담당자 사이의 책임 경계를 재설계해,
AI가 생성한 인사이트를 누가 소비하고, 어떤 SLA에 반영할지 합의하는 게 중요합니다.
국내 기업의 경우, 온프레미스와 퍼블릭 클라우드를 함께 운영하는
하이브리드 구조가 많기 때문에, 각 환경 간 데이터 거버넌스와 규제 준수도 함께 고려해야 합니다.
– 파일럿 설계 : 작게 시작해 빠르게 학습하기
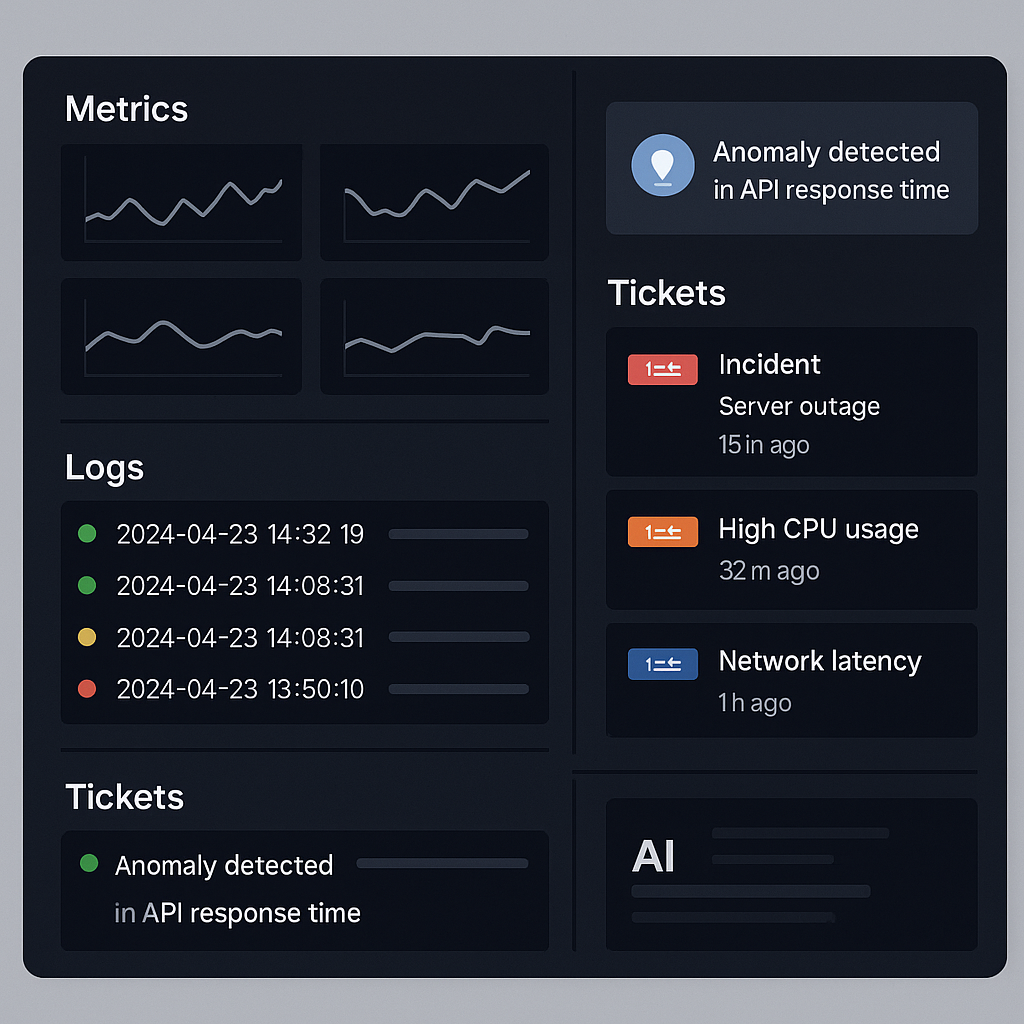
현실적인 파일럿 주제는
“특정 서비스의 장애 탐지 및 알림 최소화”처럼 범위가 명확한 과제입니다.
대상 서비스 하나를 정하고, 지난 장애 티켓과 로그를 모아 가장 빈번한 패턴과 원인을 분류한 뒤,
이 패턴에 초점을 맞춘 이상 탐지 모델을 구성합니다.
이후 1~2개월간 운영하며, 모델이 생성한 알림과 실제 장애의 관계를 리뷰하면서
임계값·룰을 조정하면, 조직에 맞는 베이스라인을 빠르게 얻을 수 있습니다.
이 과정을 통해 얻은 데이터와 인사이트는 단계 2, 3에서 더 넓은 범위의 서비스,
더 복잡한 자동 조치로 확장하는 기반이 됩니다.
– 마무리
AI 운영 자동화는 단순히 “운영 인력 절감”을 넘어, 복잡성을 관리하는 하나의 운영 전략입니다.
지금 쓰는 모니터링·로그·티켓 데이터의 흐름을 한 번 점검하고,
어떤 의사결정을 AI가 대신할 수 있을지 정의해 본다면,
다음 분기 IT 로드맵은 훨씬 구체적으로 바뀔 것입니다.
요약(핵심 요약 3줄)
– AI 운영 자동화는 IT 운영 데이터를 기반으로 장애 탐지, 원인 분석, 자원 최적화,
보안 대응까지 자동화하는 전략적 프레임입니다.
– 인프라·데이터·보안 운영이 핵심 적용 영역이며,
성공을 위해서는 솔루션 선택보다 데이터 파이프라인과 운영 모델 설계가 우선입니다.
– 작은 파일럿에서 시작해 조직에 맞는 기준과 가드레일을 만들고,
이를 기반으로 클라우드·DevOps 전체로 확장하는 접근이 효과적입니다.
*FAQ*
Q1. AIOps와 DevOps는 어떤 관계인가요?
A. DevOps는 개발과 운영의 협업과 자동화를 통해 배포 속도와 품질을 높이는 문화·프로세스이고, AIOps는 그 운영 과정에서 발생하는 데이터를 AI로 분석해 모니터링과 장애 대응을 지능화하는 기술 레이어라고 볼 수 있습니다.
Q2. 온프레미스 중심 환경에서도 AI 운영 자동화를 적용할 수 있나요?
A. 가능합니다. 다만 온프레미스 장비의 로그·메트릭을 중앙 데이터 레이크로 모으는 작업이 선행되어야 하고, 보안·규제 이슈 때문에 네트워크 분리를 어떻게 유지할지 설계가 필요합니다.
Q3. 어떤 KPI로 성과를 측정하는 것이 좋을까요?
A. 대표적으로 MTTD, MTTR, 중요 장애 건수, 알림 건수 대비 실제 이슈 비율, 그리고 클라우드 비용 대비 성능 지표를 함께 관리하면 AI 운영 자동화의 효과를 정량적으로 파악할 수 있습니다.